Este guia mostra como investigar qualquer item de despesa da POF nas cinco edições com quatro funções. Você informa o item, a medida e o corte; o pacote cuida do recorte comparável, do aluguel, dos quintis, do desenho amostral e do gráfico.
| Passo | Função | Você informa |
|---|---|---|
| 1. Achar o código | pof_buscar() |
um termo, como "celular"
|
| 2. Carregar | pof_carregar() |
edições e itens |
| 3. Descrever |
pof_analisar() + plot()
|
medida e corte |
| 4. Comparar e modelar |
pof_diferenca(), pof_modelo()
|
grupos ou fórmula |
| 5. Ir além |
pof_variacao(), pof_concentracao(),
pof_decompor(), pof_composicao(),
pof_elasticidade()
|
edições, item ou grupo |
| 6. Publicar |
pof_tabela(), pof_exportar()
|
resultado e arquivo |
| 7. Conferir |
pof_validar(), pof_ibge(),
pof_deflacionar()
|
edição e recorte |
Os blocos com microdados mostram o código para copiar. Os resultados
que rodam nesta página usam pof_exemplo(), uma base
sintética no mesmo formato, com um item chamado Jogos.
1. Achar o código do item
pof_buscar() procura o termo nos nomes das categorias e
nas descrições dos produtos originais de cada edição, sem diferenciar
acentos.
pof_buscar("aposta|loteria")
#>   codigo   nivel  nome                                                n1
#> 1  26101   folha  Jogos e apostas                                     26. Despesas diversas
#> 2  26101 produto  Jogos e apostas (DESPESAS COM JOGOS E APOSTAS)      26. Despesas diversas
#> 3  33202 produto  Outros rendimentos (GANHOS DE JOGOS ... OU PREMIOS) 33. Outros rendimentos
Um item pode ser uma folha (5 dígitos, "26101"), um
Nível 2 (3 dígitos, "172", telefonia e comunicações) ou um
Nível 1 (2 dígitos, "22", assistência à saúde), ou uma
combinação deles.
2. Carregar as edições com os itens
dados <- pof_carregar(
  anos  = c(1987, 1995, 2002, 2008, 2017),
  dir   = "HarmonizaPOF2026_data",
  itens = list(apostas  = "26101",
               celular  = c("17202", "24201"),   # serviço + aparelho
               refeicao = "16104",
               saude    = "22"))
Cada edição vira uma base por unidade de consumo com uma coluna para
cada item, os grandes grupos (Alimentação,
Habitação…) e os cortes prontos: quintil,
sexo, idade, cor,
tamanho e rm.
3. Descrever o item
pof_analisar() calcula a medida em cada edição, com IC
de 95% quando há desenho amostral (2002 em diante).
-
medida = "prevalencia": % de UCs com gasto no item. -
medida = "participacao": % do item na despesa de consumo. -
medida = "gasto_medio": gasto mensal médio por UC. Os valores são nominais; compare só dentro da edição.
b <- pof_exemplo()
r <- pof_analisar(b, "Jogos", medida = "prevalencia", por = "quintil")
r
#> Item: Jogos | % das UCs com gasto
#> Recorte: Brasil  | por quintil
#>
#>     Edicao  Grupo Estimativa IC_inf IC_sup  N_UC
#>     <char> <char>      <num>  <num>  <num> <int>
#> 1: exemplo      1      15.83  12.03  19.64   395
#> 2: exemplo      2      14.17  10.32  18.02   384
#> 3: exemplo      3      13.86  10.40  17.33   398
#> 4: exemplo      4      13.82  10.48  17.15   416
#> 5: exemplo      5      15.18  11.74  18.62   407
plot(r)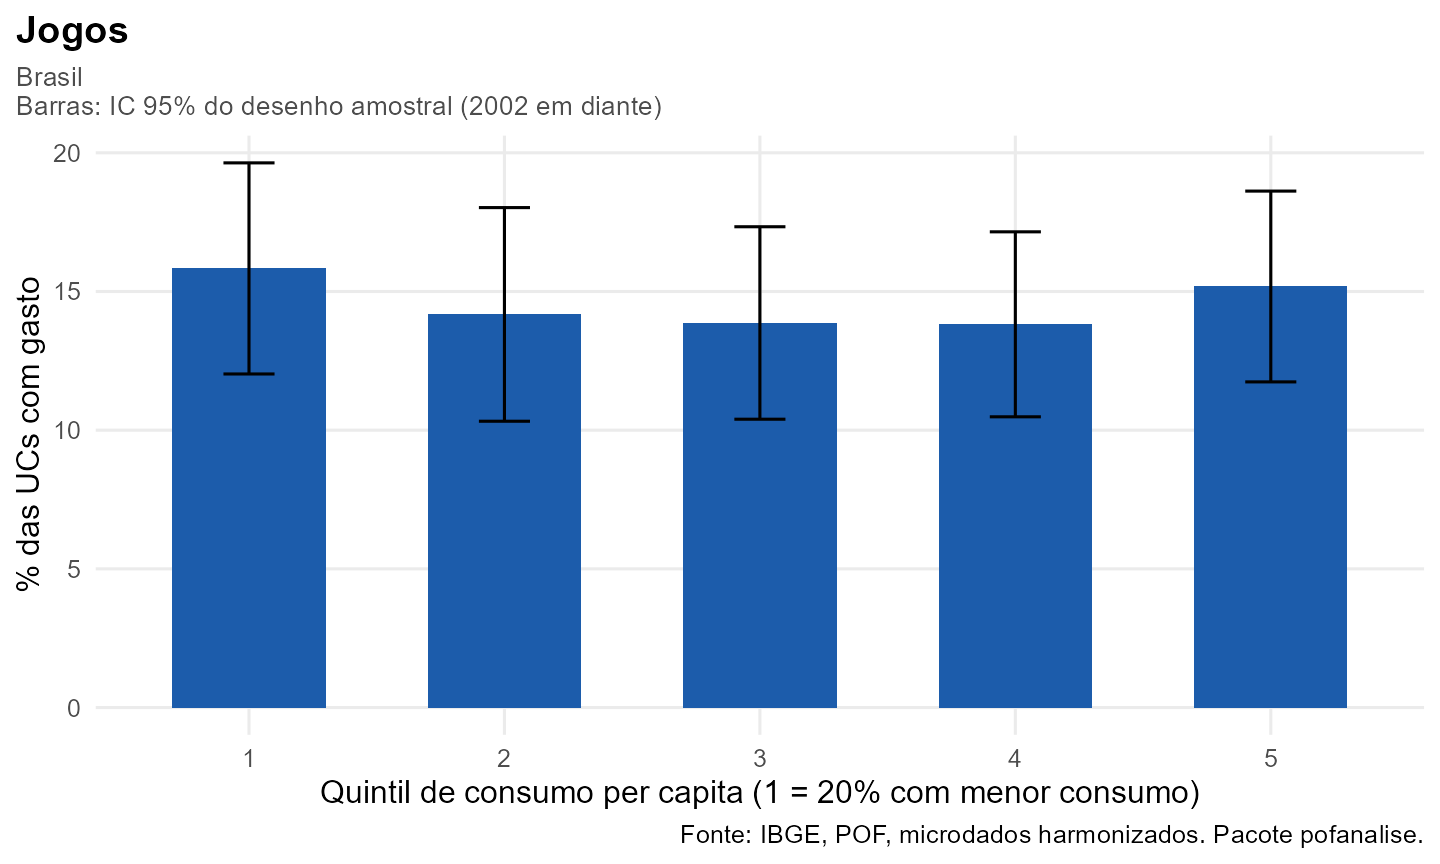
Escolhas automáticas. Se houver 1987 ou 1995 entre
as edições, o recorte passa a ser o das regiões metropolitanas e o
aluguel sai do consumo, para que a comparação seja válida. As escolhas
ficam registradas no resultado (attr(r, "escolhas")) e no
subtítulo do gráfico. Para mudar: recorte = "brasil" e
sem_aluguel = FALSE.
pof_analisar(dados, "apostas")                                   # série, RMs
pof_analisar(dados[3:5], "celular", medida = "participacao",
             por = "quintil")                                    # Brasil, 2002 em diante
plot(pof_analisar(dados, "refeicao", medida = "participacao", por = "quintil"))
4. Comparar grupos e modelar
pof_diferenca() estima a diferença entre as categorias
de um corte e uma categoria de referência, com IC e p-valor, por
regressão com o desenho amostral.
pof_diferenca(b, "Jogos", por = "sexo", referencia = "Mulher")
#>     Edicao  Grupo Referencia Diferenca   IC_inf   IC_sup      p_valor
#>     <char> <char>     <char>     <num>    <num>    <num>        <num>
#> 1: exemplo  Homem     Mulher  7.116923 3.948426 10.28542 1.270918e-05
pof_modelo() ajusta um modelo logístico para a chance de
ter gasto com o item (tipo = "prevalencia", resultados em
razão de chances) ou um modelo para o log do gasto entre quem gasta
(tipo = "gasto").
pof_modelo(b, "Jogos", ~ quintil + sexo + idade)
#>     Edicao           Termo Estimativa    IC_inf    IC_sup      p_valor  N_UC
#>     <char>          <char>      <num>     <num>     <num>        <num> <int>
#> 1: exemplo     (Intercept)  0.2988962 0.2071959 0.4311810 2.492958e-10  2000
#> 2: exemplo        quintil2  0.9119739 0.6025568 1.3802789 6.623442e-01  2000
#> 3: exemplo        quintil3  0.8735345 0.5843385 1.3058569 5.090149e-01  2000
#> 4: exemplo        quintil4  0.8305089 0.5511635 1.2514345 3.738310e-01  2000
#> 5: exemplo        quintil5  0.9755144 0.6591992 1.4436125 9.011269e-01  2000
#> 6: exemplo      sexoMulher  0.5679579 0.4366322 0.7387824 2.865166e-05  2000
#> 7: exemplo    idade45 a 59  0.6721728 0.4603030 0.9815627 3.979740e-02  2000
#> 8: exemplo idade60 ou mais  0.8731497 0.6320153 1.2062849 4.098852e-01  2000
#> 9: exemplo     idadeAté 29  0.6090394 0.4060918 0.9134117 1.660420e-02  2000
Com os microdados de 2017-2018, por exemplo,
pof_modelo(dados["2017-2018"], "apostas", ~ quintil + sexo + cor)
estima a chance de gasto com jogos e apostas por quintil, sexo e cor da
pessoa de referência, controlando as demais.
5. Ferramentas para ir além
A mudança é significativa?
pof_variacao() compara duas edições de um resultado,
grupo a grupo, com IC e p-valor. Como as amostras de edições diferentes
são independentes, o erro-padrão da diferença combina os dois.
a <- pof_exemplo(semente = 1); a$Edicao <- "2008-2009"
d <- pof_exemplo(semente = 2); d$Edicao <- "2017-2018"
dois <- list(a, d)
r <- pof_analisar(dois, "Jogos", por = "sexo")
pof_variacao(r, de = "2008-2009", para = "2017-2018")
#> Key: <Grupo>
#>     Grupo       De     Para  Diferenca    IC_inf   IC_sup   p_valor
#>    <char>    <num>    <num>      <num>     <num>    <num>     <num>
#> 1:  Homem 18.25995 17.19057 -1.0693777 -4.561455 2.422700 0.5483662
#> 2: Mulher 11.14303 11.88287  0.7398379 -2.189179 3.668855 0.6205473
#>    Significativa
#>           <lgcl>
#> 1:         FALSE
#> 2:         FALSE
O gasto é progressivo ou regressivo?
pof_concentracao() ordena as pessoas pelo consumo per
capita e mede como o gasto com o item se distribui. O índice
K compara a concentração do item com a do consumo:
negativo, o item pesa mais no orçamento de quem consome menos; positivo,
de quem consome mais. Base40 e Topo20 dizem
quanto do gasto total vem dos 40% com menor consumo e dos 20% com maior
consumo.
pof_concentracao(b, c("Alimentação", "Educação", "Transporte"))
#>     Edicao        Item         C Gini_consumo           K   Base40   Topo20
#>     <char>      <char>     <num>        <num>       <num>    <num>    <num>
#> 1: exemplo Alimentação 0.3962962    0.4272836 -0.03098731 16.81342 46.23397
#> 2: exemplo    Educação 0.4758786    0.4272836  0.04859505 12.67206 52.30526
#> 3: exemplo  Transporte 0.4438190    0.4272836  0.01653549 13.64444 49.36941
#>    Classificacao
#>           <char>
#> 1:    Regressivo
#> 2:   Progressivo
#> 3:   Progressivo
Comportamento ou composição?
Uma participação pode mudar porque as famílias mudaram o que compram
ou porque mudou o tipo de família (mais idosos, mais gente morando
sozinha). pof_decompor() separa os dois efeitos; a soma é
exatamente a variação total.
dc <- pof_decompor(dois, "Alimentação", por = "tamanho", de = "2008-2009", para = "2017-2018")
dc$resumo
#>           Item     Por        De      Para Participacao_de Participacao_para
#>         <char>  <char>    <char>    <char>           <num>             <num>
#> 1: Alimentação tamanho 2008-2009 2017-2018        25.10789          25.93531
#>    Variacao_total Efeito_comportamento Efeito_composicao
#>             <num>                <num>             <num>
#> 1:      0.8274194            0.8208683       0.006551145
dc$grupos
#> Key: <Grupo>
#>                  Grupo   Peso_de Peso_para  Part_de Part_para Comportamento
#>                 <char>     <num>     <num>    <num>     <num>         <num>
#> 1:           1 morador  4.937976  4.913930 29.32503  28.59313   -0.03605281
#> 2:         2 moradores  8.862293  9.466389 27.13112  27.58409    0.04151198
#> 3:     3 a 4 moradores 33.891357 32.747131 25.09952  25.95637    0.28549804
#> 4: 5 ou mais moradores 52.308374 52.872549 24.37243  25.38005    0.52991106
#>     Composicao
#>          <num>
#> 1: -0.00696331
#> 2:  0.16526625
#> 3: -0.29209732
#> 4:  0.14034553
Do que é feito um grupo?
pof_composicao() abre um grupo nas suas partes: um
grande grupo ("Alimentação") nas categorias de Nível 1, ou
um Nível 1 não alimentar ("22", saúde) nas folhas.
pof_composicao(dados, "22")              # remédios, plano, consultas...
pof_composicao(dados, "Alimentação", por = "quintil")
Elasticidade de qualquer item
pof_elasticidade(b, "Alimentação", por = "sexo")[, .(Grupo, elasticidade = round(elasticidade, 2), N)]
#>     Grupo elasticidade     N
#>    <char>        <num> <int>
#> 1: Mulher         0.89  1029
#> 2:  Homem         0.94   971
Levar para o artigo
pof_tabela() monta a tabela larga (grupos nas linhas,
edições nas colunas, IC entre colchetes) e pof_exportar()
grava em CSV que o Excel em português abre direto.
pof_tabela(pof_analisar(dois, "Jogos", por = "quintil"))
#> Key: <Grupo>
#>     Grupo         2008-2009         2017-2018
#>    <char>            <char>            <char>
#> 1:      1 15,8 [12,0; 19,6] 15,4 [11,3; 19,5]
#> 2:      2 14,2 [10,3; 18,0] 16,4 [12,5; 20,3]
#> 3:      3 13,9 [10,4; 17,3] 16,6 [12,9; 20,2]
#> 4:      4 13,8 [10,5; 17,2]  13,2 [9,8; 16,5]
#> 5:      5 15,2 [11,7; 18,6]  11,0 [7,9; 14,1]
pof_exportar(pof_tabela(r), "apostas_por_sexo.csv")Valores em reais de hoje e conferência com o IBGE
pof_deflacionar() converte gastos médios para reais de
janeiro de 2018 (ou de outra data) pelo IPCA, o que permite comparar
valores de 1995-1996, 2002-2003, 2008-2009 e 2017-2018.
pof_validar() confronta as estimativas com as tabelas
oficiais do IBGE (pof_ibge()), item a item; ver Validação com o IBGE. Os cortes
por = "regiao" (Grande Região) e
por = "situacao" (urbana/rural) também estão
disponíveis.
pof_deflacionar(pof_analisar(dados[2:5], "apostas", medida = "gasto_medio"))
pof_analisar(dados["2017-2018"], "Alimentação", medida = "participacao", por = "regiao")
Cuidados
- Comparar edições. Use o recorte das RMs com consumo sem aluguel (o padrão quando há 1987 ou 1995).
-
Itens raros. Em recortes pequenos (uma RM, um
quintil) o IC fica largo; confira
N_UCe a largura do intervalo antes de interpretar diferenças. -
Qualidade da harmonização. Confira a nota da folha
em
pof_harmonizacao()$folhasou no explorador. Folhas com qualidade média ou baixa podem estar ausentes em alguma edição. - 1987 e 1995 não têm desenho amostral: as estimativas saem sem IC.